شرائح الذكاء الاصطناعي 2026: علي بابا V900 ضد إنفيديا
Photo: Jeremy Waterhouse
النقاط المغطاة في المقال
أعلنت علي بابا يوم 22 سبتمبر 2026 عن شريحة Zhenwu V900 في مؤتمر Apsara السنوي، ورفعت هدفها إلى 20 جيجاواط من مراكز البيانات بحلول 2032، مع خطة إنفاق تتجاوز 53 مليار دولار خلال ثلاث سنوات. هذه القفزة ليست خبراً صينياً فحسب، بل تحرك مباشر في صميم سوق شرائح الذكاء الاصطناعي 2026 الذي تحتكره إنفيديا بأكثر من 90%.
القصة أهم مما تبدو للقارئ العربي: أسعار الاشتراكات في ChatGPT وGemini وClaude، وتكلفة GPU في السحابة، وحتى سعر بطاقة الرسومات التي تحلم بشرائها، كلها مرتبطة مباشرة بشدة هذه المنافسة. حين تدخل شريحة صينية جديدة تدّعي أداءً ثلاثة أضعاف سلفها ومقارنة بـ H20 من إنفيديا، تتحرك الأسعار عبر السلسلة بأكملها.
في هذا الدليل نفكك ما أعلنته علي بابا فعلياً بالأرقام، ونقارنه بشرائح إنفيديا H20 وH200 وهواوي Ascend 910C و950PR، ثم نجيب على السؤال الوحيد الذي يهم المطور ورائد الأعمال العربي: هل ستنخفض تكلفة الذكاء الاصطناعي لديك خلال 2027، أم سترتفع أكثر؟
زنوو V900: أحدث شرائح الذكاء الاصطناعي 2026 من علي بابا
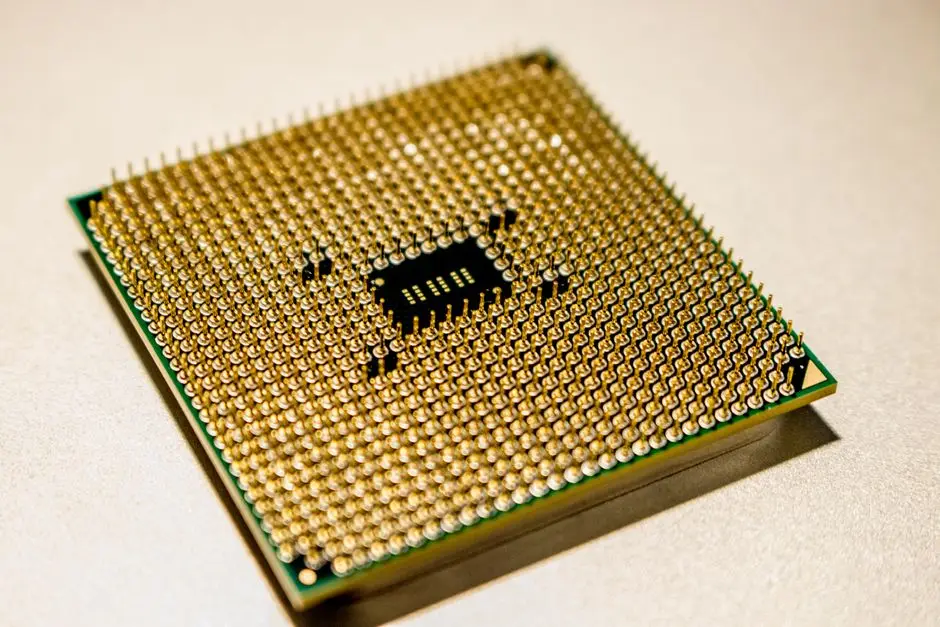
Zhenwu V900 هي الشريحة الثالثة من عائلة زنوو التي تطورها وحدة T-Head التابعة لعلي بابا. الإعلان جاء في مؤتمر Apsara Conference يوم 22 سبتمبر 2026 في هانغتشو، وتقول علي بابا إن الشريحة توفر أداءً يبلغ ثلاثة أضعاف سلفها Zhenwu M890 الذي أُطلق في مايو 2026، والذي كان بدوره أسرع ثلاث مرات من Zhenwu 810E.
الرقم الأهم في الإعلان ليس الأداء الفردي، بل قدرة التجميع: عنقود واحد يستوعب حتى 500 ألف شريحة V900 تعمل معاً لتدريب النماذج العملاقة والاستدلال منها. للمقارنة، أكبر عناقيد إنفيديا التجارية اليوم تعمل بعشرات الآلاف من H100 وB200، والوصول إلى نصف مليون شريحة في عنقود واحد يعادل مركز بيانات بحجم دولة صغيرة.
الجدول الزمني للإنتاج والتوفر
الإنتاج التجاري الشامل لـ V900 مخطط له في الربع الأول من 2027، ما يعني أن مراكز بيانات علي بابا كلاود ستكون أول المستفيدين. الشريحة الحالية Zhenwu M890 موجودة بالفعل في خدمة الإنتاج، وأعلنت علي بابا في أبريل 2026 عن مركز بيانات يعمل بعشرة آلاف شريحة زنوو. النموذج الأولي من عائلة T-Head المعروف باسم PPU (وحدة معالجة متوازية) يحمل 96 جيجابايت من ذاكرة HBM2e وعرض نطاق 700 جيجابايت/ث بين الشرائح، ويعتمد واجهة PCIe 5.0 x16 عند استهلاك 400 واط، وفقاً لتقارير Tom's Hardware.
ما وراء الشريحة: خطة نماذج Qwen العملاقة
الشريحة ليست الحدث الوحيد. أعلن فريق Qwen في نفس المؤتمر عن قفزة معمارية للتعامل مع مهام أطول أفقياً. نموذجا Qwen 4.5 وQwen 5 القادمان سيصلان إلى 5 إلى 10 تريليون معامل. هذا يفسر الحاجة إلى عناقيد بنصف مليون شريحة، فالنماذج بهذا الحجم تتطلب طاقة حوسبة لا توفرها شريحة منفردة اليوم.
الالتزام الاستثماري بـ 53 مليار دولار خلال ثلاث سنوات يضع علي بابا في المقدمة بين مقدمي الحوسبة السحابية الصينيين. الرقم يتجاوز ما تنفقه Tencent وByteDance مجتمعتين على البنية التحتية للذكاء الاصطناعي.
لماذا اختارت علي بابا الإعلان الآن؟
التوقيت ليس صدفة. مؤتمر Apsara هو أكبر منصة تقنية لعلي بابا كلاود، ومن الضروري إظهار قوة الحوسبة أمام المنافسين المحليين. عوامل ثلاثة تحكم القرار: أولاً، حظر تصدير أحدث شرائح إنفيديا للصين يترك فراغاً كبيراً في السوق. ثانياً، DeepSeek وMoonshot تدفعان النماذج مفتوحة المصدر بقوة، والسحابة التي تشغل هذه النماذج بكفاءة تربح السباق. ثالثاً، الأسهم الصينية الكبرى تشهد ضغطاً على التقييمات، وإعلان بحجم V900 يعيد الثقة للمستثمرين.
إنفيديا H20 وH200: شرائح الذكاء الاصطناعي التي تحكم السوق
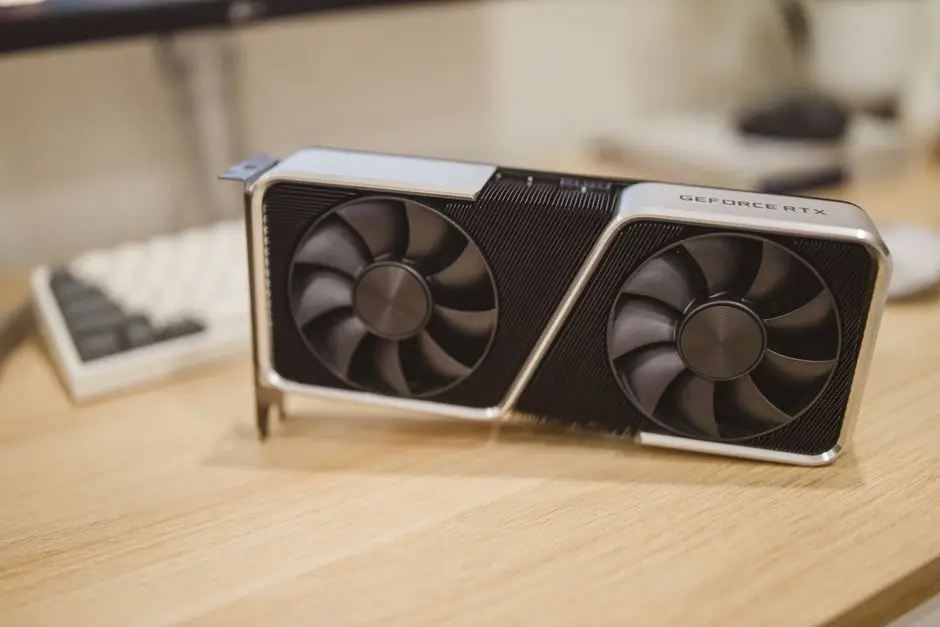
قبل الحديث عن شريحة علي بابا، لا بد من فهم ما تقدمه إنفيديا للسوق الصيني، لأن V900 مصممة أساساً كبديل لها. شريحة H20 هي أحدث إصدار سُمح لإنفيديا ببيعه للصين ضمن قيود التصدير الأمريكية، وتحمل 96 جيجابايت من ذاكرة HBM3 (وليس HBM2e مثل PPU من علي بابا) وعرض نطاق ذاكرة يبلغ 4000 جيجابايت/ث، مبنية على معمارية Hopper مع 14,592 نواة CUDA واستهلاك 400 واط.
الفرق الأهم بين H20 وZhenwu هو نضج المنظومة البرمجية. H20 تعمل مع CUDA وTensorRT وكل مكتبات الذكاء الاصطناعي التي درج عليها المطورون منذ عشر سنوات. سعر التأجير في السحابة يبدأ من 0.34 دولار للساعة على GPU واحد، ومنذ أواخر 2024 شحنت إنفيديا أكثر من مليون شريحة H20 للصين، مقابل توقعات بشحن هواوي Ascend بما يعادل خُمس شحنات H20 خلال 2026 بحسب تقارير Yahoo Finance.
H200 والقفزة إلى ذاكرة أكبر
الرفيقة الأقوى في العائلة هي H200 التي تحمل 141 جيجابايت HBM3E، وتُستخدم في مراكز البيانات التجارية للسحابات الغربية الكبرى. سعر الوحدة اليوم بين 30 و40 ألف دولار، ومن المتوقع ارتفاعها في 2026 لأن كل وحدة تستهلك ست حزم من HBM3E ارتفعت أسعارها بنحو 20%. أما تكلفة تأجير H100 السحابية فقفزت من 1.70 إلى 2.35 دولار للساعة (زيادة 40%) بعد أن اختفت السعة المتاحة من السوق في أواخر 2025.
لماذا لا تنافس علي بابا في السحابات الغربية بعد؟
V900 لن تصل إلى AWS أو Azure أو Google Cloud قريباً. حظر التصدير الأمريكي يمنع الشركات الصينية من البيع للعملاء العسكريين والحكوميين. حتى البيع للمؤسسات المدنية الغربية يواجه عقبات تنظيمية معقدة.
المنافسة الفعلية تدور داخل الصين وفي أسواق ثالثة مثل جنوب شرق آسيا والشرق الأوسط. تجدر الإشارة إلى أن السعودية والإمارات وقعتا صفقات ضخمة مع إنفيديا. هيوماين ون السعودي يعتمد 150 ألف معالج. وطلبت HUMAIN 18 ألف شريحة GB300 في أكبر طلب سيادي في 2026.
سؤال الوثوقية: هل تستطيع علي بابا فعلاً؟
هنا يكمن الشك. علي بابا اعترفت في مايو 2026 أنها تكافح لمواكبة منافسيها. تصنيع الشرائح المتقدمة يعتمد على مصنع SMIC الصيني الذي يواجه قيوداً في الوصول إلى معدات ASML الحديثة. الإنتاج بحجم يشغل عناقيد نصف مليون شريحة يحتاج قدرة تصنيع لا تملكها الصين بالكامل بعد. الخطة معلنة، لكن التنفيذ في 2027 هو الاختبار الحقيقي.
هواوي Ascend: الصف الثاني من شرائح الذكاء الاصطناعي الصينية
علي بابا ليست الوحيدة التي تلاحق إنفيديا داخل الصين. هواوي سبقت إلى السوق بمنتجها Ascend 910C، شريحة مصنعة بتقنية 7 نانومتر من مصنع SMIC المحلي، وتخطط الشركة لإنتاج 600 ألف وحدة خلال 2026. عملاؤها الأساسيون: علي بابا وTencent وDeepSeek. وهنا تظهر المفارقة: علي بابا التي طرحت V900 لتنافس إنفيديا كانت تشتري شرائح هواوي قبل ذلك.
Ascend 950PR: الشريحة الأشرس بيانياً
الإصدار الأحدث من هواوي هو Ascend 950PR الذي يقدم 1.56 بيتافلوبس في الاستدلال، وتقول هواوي إنه يتفوق على H20 بأداء 2.8 أضعاف في FP4. الشركة تخطط لإنتاج 750 ألف وحدة في 2026، والتزمت ByteDance بطلبات بقيمة 5.6 مليار دولار. الشريحة الثالثة Ascend 920 تعتمد عملية 6 نانومتر وبدأ إنتاجها الشامل في النصف الثاني من 2025.
DeepSeek والنماذج مفتوحة المصدر
الجانب المكمل للأجهزة هو النماذج نفسها. DeepSeek V4 يقدم أداءً قريباً من Claude Opus 4.7 بسعر 0.28 دولار لكل مليون توكن. النموذج أرخص بسبع مرات ويعمل على شرائح هواوي بكفاءة عالية. هذه المعادلة تجمع بين شرائح صينية ونماذج مفتوحة المصدر، ما يتيح للسحابات الصينية تقديم خدمات ذكاء اصطناعي بأسعار تكسر السقف الغربي.
راجع دليلنا لـ الذكاء الاصطناعي مفتوح المصدر 2026 للاطلاع على الفارق السعري الفعلي بين النماذج المغلقة والمفتوحة.
Cambricon وBiren: المنافسون الأصغر
خارج علي بابا وهواوي، شركتان صينيتان تدفعان بشرائح خاصة. Cambricon تعمل على شرائح Siyuan للاستدلال في المؤسسات المتوسطة. Biren الأصغر حجماً تركز على وحدات GPU للألعاب والاستدلال. هذه الشرائح لن تصل إلى السوق العربية بصورة مستقلة، لكنها ستدخل ضمن الحلول السحابية الصينية التي تخدم عملاء إقليميين.
مقارنة شاملة: شرائح الذكاء الاصطناعي 2026 بالأرقام
جمعنا الأرقام الرسمية والمعلنة من الشركات الأربع الأبرز في سوق شرائح الذكاء الاصطناعي 2026. لاحظ أن مقارنة الأداء الخام صعبة لأن كل شريحة تقاس بمعايير مختلفة (FP16, FP8, FP4)، لذا نركز على العناصر التي يمكن التحقق منها مباشرة.
| الشريحة | الذاكرة | عرض النطاق | الاستهلاك | الإنتاج التجاري | السوق المستهدف |
|---|---|---|---|---|---|
| Alibaba Zhenwu V900 | غير معلن رسمياً | غير معلن | غير معلن | الربع الأول 2027 | الصين، سحابات إقليمية |
| Alibaba T-Head PPU | 96 جيجا HBM2e | 700 جيجا/ث | 400 واط | متوفرة | الصين |
| Nvidia H20 | 96 جيجا HBM3 | 4000 جيجا/ث | 400 واط | متوفرة | الصين (بترخيص) |
| Nvidia H200 | 141 جيجا HBM3E | 4800 جيجا/ث | 700 واط | متوفرة | عالمي |
| Huawei Ascend 950PR | غير معلن | غير معلن | غير معلن | 2026 | الصين |
| Huawei Ascend 910C | غير معلن | غير معلن | غير معلن | 2025 | الصين |
القراءة السريعة للجدول توضح أن إنفيديا لا تزال المرجع من ناحية الشفافية والنضج، لكن الشرائح الصينية تتفوق في اعتبارين: الحصول عليها لا يحتاج ترخيص تصدير أمريكي، وسعرها داخل الصين أقل بكثير من H20 المستوردة. المنافسة الحقيقية لن تُحسم بمعايير الأداء بل بالأنظمة البرمجية ونضج المطورين، وهنا يمنح تفوّق CUDA إنفيديا أسبقية بسنوات.
أثر شرائح الذكاء الاصطناعي 2026 على المستخدم العربي
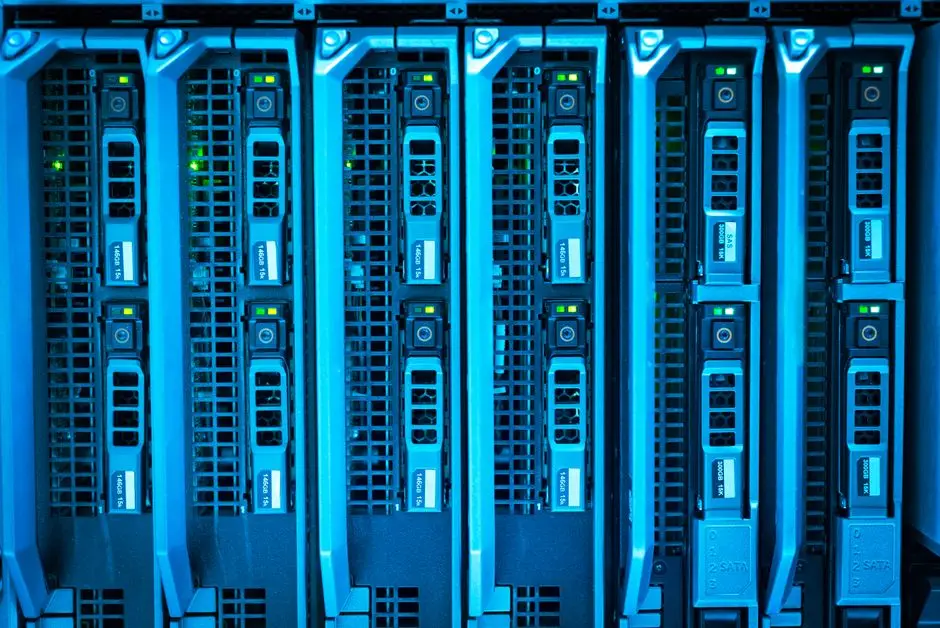
السؤال الذي يطرحه كل قارئ عربي: هل هذه المعركة تجعل ChatGPT أرخص أم أغلى في 2027؟ الإجابة تعتمد على ثلاث موجات متتابعة تتشكل الآن.
الموجة الأولى: أسعار GPU السحابية
حين تعمل علي بابا كلاود بعناقيد V900 محلية، تنخفض تكلفتها التشغيلية داخل الصين، ما يتيح لها تقديم Qwen والنماذج المستضافة بأسعار قد تكون نصف نظيراتها الغربية. هذا يضغط على AWS وAzure وGoogle Cloud لتقديم عروض تنافسية في الأسواق التي يلتقي فيها الطرفان، ومنها الإمارات ومصر. النتيجة المتوقعة للمطور العربي: أسعار API الذكاء الاصطناعي تستمر في الانخفاض خلال 2027، خاصة للنماذج الصينية مفتوحة المصدر عبر مزودين إقليميين.
الموجة الثانية: أزمة الذاكرة تستمر
الوجه المظلم للقصة أن كل جيل جديد من هذه الشرائح يستهلك ذاكرة HBM بكميات ضخمة. أسعار HBM ارتفعت بنسب مئوية ضخمة في الأشهر الأخيرة، وذاكرة الفيديو VRAM تمثل الآن أكثر من 80% من كلفة تصنيع بعض الشرائح المتقدمة. هذا هو نفس السبب وراء أزمة الرام DDR5 التي رفعت أسعار الذاكرة أربع مرات في السوق الاستهلاكية. كلما زاد الطلب على شرائح الذكاء الاصطناعي، ضاق المعروض للاستخدامات الاستهلاكية، وارتفع سعر بطاقة الرسومات لديك بشكل غير مباشر. راجع دليل أسعار بطاقات الرسومات 2026 لفهم الصورة الاستهلاكية.
الموجة الثالثة: السيادة الرقمية العربية
السعودية والإمارات لا تنتظران هذه الحرب لتحسم لهما الاختيار. مشروع هيوماين ون السعودي يعتمد على Nvidia GB300 بواقع 18 ألف شريحة مع شراكات AWS. مركز UAE-US AI Campus في أبوظبي يوظف عشرات الآلاف من شرائح إنفيديا. القرار السيادي في المنطقة يميل نحو المعسكر الأمريكي رغم توفر بدائل صينية أرخص.
السبب واضح: نضج المنظومة البرمجية وتوافقها مع الشراكات العسكرية والأمنية القائمة. راجع دليل وكلاء الذكاء الاصطناعي 2026 لفهم منظومة الخدمات المبنية فوق هذه الشرائح.
الموجة الرابعة: فرص المطور المستقل
هنا يظهر الجانب الإيجابي للحرب. مع توسع علي بابا كلاود إقليمياً وتوفر خدمات Qwen بأسعار مخفضة، يستطيع المطور العربي المستقل بناء تطبيقات ذكية بكلفة أقل بنسبة 40 إلى 60% مقارنة بـ 2024. مشاريع الشركات الناشئة التي تعتمد استدعاء API متكرر تربح الأكثر. تطبيق يعالج مليون طلب شهرياً يوفر مئات الدولارات باستخدام DeepSeek V4 بديلاً عن GPT-5.5.
أي شريحة من شرائح الذكاء الاصطناعي 2026 تعنيك؟
لن تشتري أياً من هذه الشرائح مباشرة، لكن كل قرار تقني تتخذه في 2026 و2027 يعتمد على أي شريحة ستشغل خدمتك. إليك المسار العملي لكل حالة.
للمطور والشركة الناشئة العربية
أفضل خيار الآن هو مزيج: استخدم Claude أو GPT-5.6 للجودة عبر API الغربية، مع نموذج صيني مفتوح المصدر مثل DeepSeek V4 أو Qwen للتكاليف المنخفضة. تشغيل DeepSeek عبر Together.ai أو Fireworks بسعر 0.28 دولار لكل مليون توكن يوفر 70% من تكلفة Claude Opus مع أداء مقبول لمعظم المهام. راجع مقارنتنا الكاملة في أفضل ذكاء اصطناعي للبرمجة 2026.
لمالك مركز بيانات إقليمي
إنفيديا H200 لا تزال الرهان الآمن رغم سعرها (30 إلى 40 ألف دولار للوحدة) بسبب نضج CUDA وسهولة توظيف المهندسين. تجاوز H100 إلى H200 مباشرة إن كنت تبدأ الآن، لأن حجم الذاكرة 141 جيجا يفتح باب النماذج الأكبر. الاستثمار في شرائح صينية غير مجدٍ حالياً إلا إن كان لديك عقد مباشر مع علي بابا كلاود أو Tencent.
لمستخدم ChatGPT وGemini العادي
لن تتأثر مباشرة بهذه الحرب على المدى القصير. سعر اشتراك ChatGPT Plus بواقع 20 دولاراً وGemini Advanced وClaude Pro لا يتحرك سنوياً. ما سيتغير هو حدود الاستخدام في الخطة المجانية والمدفوعة. كذلك ستتغير سرعة الاستجابة وتوفر النماذج الأكبر لأصحاب الاشتراكات الأرخص. راجع أفضل ذكاء اصطناعي 2026 للاختيار الحالي بين المنصات.
لصانع محتوى وطالب
ركز على النموذج لا على الشريحة. NotebookLM من جوجل يعمل على شرائح TPU خاصة. Claude يعمل على AWS Trainium. Gemini يعمل على TPU جوجل. طبقة التطبيق هي التي تحدد تجربتك، والشريحة في الخلفية لن تراها.
الاستثناء الوحيد: إذا كنت تدير خادماً محلياً لتشغيل نماذج مفتوحة المصدر، فتوجه إلى GPU من فئة RTX 4090 أو 5090 التي تحمل ذاكرة كافية للنماذج المضغوطة.
لفريق تقني في شركة إقليمية
الاختيار الأذكى لعام 2027 هو الحلول الهجينة. لا تلتزم بمزود سحابي واحد. اربط تطبيقك بطبقة توجيه ذكية مثل OpenRouter أو LiteLLM. هذه الأدوات تتيح لك اختيار النموذج الأنسب لكل طلب بشكل ديناميكي. المهام السريعة توجَّه إلى نماذج صينية رخيصة، والمهام المعقدة إلى Claude أو GPT-5.6. النتيجة: توفير 50% في التكاليف بدون خسارة في الجودة الحرجة.
للمستثمر التقني
سهم علي بابا قفز نحو 3% في بورصة هونغ كونغ بعد الإعلان، وارتفع في التداول الأمريكي قبل افتتاح السوق بأكثر من 2%. لكن المستثمر الحذر يعلم أن هذه الأسعار قد تكون فقاعة. عوامل الحسم: قدرة SMIC على التصنيع بكميات كبيرة، ومصير حظر التصدير الأمريكي في إدارة ترامب الثانية، ومدى نجاح Qwen 5 في اختبارات الأداء الفعلية.
أسئلة شائعة حول شرائح الذكاء الاصطناعي 2026
هذه أكثر الأسئلة تكراراً حول موجة الشرائح الجديدة وأثرها.
المصادر
كل الأرقام والمواصفات في هذا الدليل تعود إلى المصادر التالية التي راجعناها مباشرة أثناء الكتابة:
- CNBC: Alibaba shares jump as new AI chip, data center buildout plans unveiled
- Bloomberg: Alibaba Unveils AI Chip to Drive 20GW of Data Centers by 2032
- Tom's Hardware: Alibaba AI chip goes head-to-head with Nvidia H20
- Yahoo Finance: Alibaba-developed AI processor on par with Nvidia's H20
- South China Morning Post: Huawei to roll out AI chips as alternative to Nvidia H20
- Spheron: GPU Cloud Providers in the Middle East 2026
- Bloomberg: AI-Driven Memory Chip Shortage
- Wikipedia: T-Head (Alibaba semiconductor unit)
أسئلة شائعة
هل ستنخفض أسعار اشتراكات الذكاء الاصطناعي بسبب شريحة Zhenwu V900؟▾
هل تتفوق شريحة علي بابا Zhenwu V900 على إنفيديا H20 فعلياً؟▾
هل تستطيع الشركات العربية شراء شرائح Zhenwu V900؟▾
ما بديل إنفيديا الأفضل للسوق العربي؟▾
متى تصل خدمات علي بابا كلاود الجديدة بشريحة V900 للسوق العربي؟▾